Amazon Web Services confirmó el 15 de septiembre que no puede recuperar datos ni recursos de clientes alojados en dos de las zonas que sus centros de datos en Medio Oriente tenían activas antes de los ataques de Irán, ocurridos seis meses antes.
La pérdida alcanza a toda la región Medio Oriente (Baréin), identificada como me-south-1, y a una de las tres zonas de disponibilidad de la región Medio Oriente (EAU), la mec1-az2.
Según Uptime Institute, es el primer ataque militar confirmado contra la infraestructura física de un proveedor de nube hiperescala.
Seis meses, tres golpes
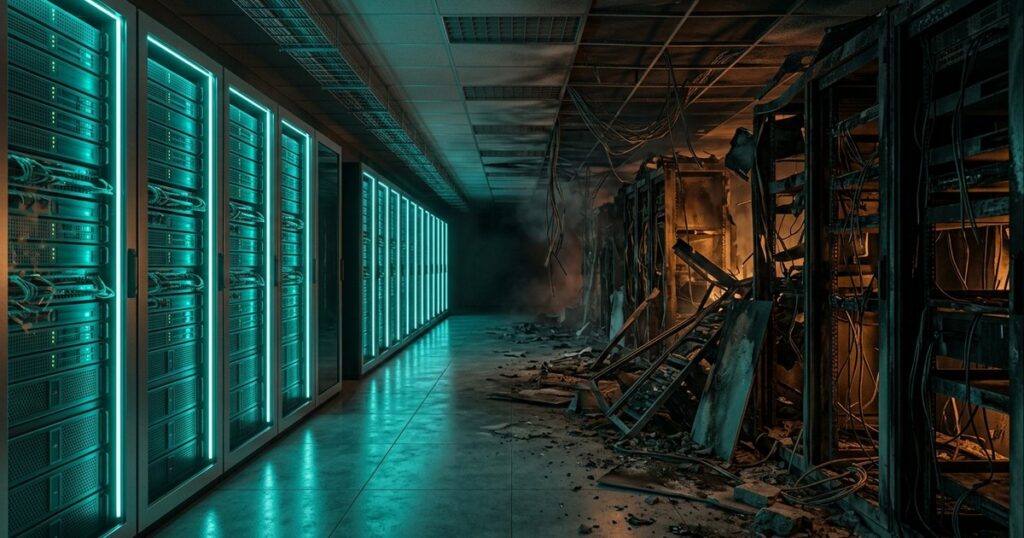
Todo empezó el 1° de marzo, cuando drones impactaron directamente dos de las tres zonas de disponibilidad de la región de EAU y dañaron por onda expansiva una instalación cercana en Baréin.
El daño incluyó estructura, corte de energía y, en algunos casos, agua de los sistemas de supresión de incendios activados por el fuego.
Irán volvió sobre Baréin un mes después y, en julio, atacó por tercera vez lo que quedaba en pie de esa región. La Guardia Revolucionaria (IRGC) reivindicó los tres ataques y dijo apuntar a AWS por alojar cargas de trabajo militares y de inteligencia de Estados Unidos.
Entre los servicios que salieron de línea en cada corte estuvieron EC2, S3, DynamoDB, Lambda y RDS. Entre las organizaciones que reportaron impacto:
- Abu Dhabi Commercial Bank.
- Emirates NBD y First Abu Dhabi Bank.
- Las plataformas de pago Hubpay y Alaan.
- Snowflake, que corre parte de su infraestructura sobre AWS en la región.
- Careem, la app de viajes.
Lo que dijo AWS el 15 de septiembre
Fue la primera actualización pública de AWS sobre el incidente desde abril. En su panel de estado, la empresa fue directa: «el daño a nuestra infraestructura abarcó múltiples zonas de disponibilidad y superó lo que nuestros servicios regionales y multi-AZ están diseñados para resistir».
Sobre Baréin: «no podemos restablecer el acceso a los recursos y datos alojados exclusivamente en esta región». Sobre la zona dañada en EAU, el mismo texto, acotado a mec1-az2.
AWS agregó que evaluó toda la infraestructura afectada y agotó cada opción de recuperación de datos y recursos que no habían sido migrados antes del corte.
«Pérdida permanente» no es «todos perdieron todo»
El matiz importa. AWS también dijo que, desde marzo, la mayoría de los clientes ya había restablecido sus operaciones en otras regiones, restaurando backups o copiando datos que seguían siendo accesibles.
La pérdida definitiva quedó para quienes tenían recursos o datos alojados exclusivamente en la zona golpeada, sin réplica en otra región ni backup fuera de AWS.
Es, en los hechos, el escenario que el modelo de responsabilidad compartida de AWS describe desde siempre: la nube es responsable de la infraestructura física y de que cada servicio cumpla el nivel de resiliencia que promete (por ejemplo, sobrevivir a la caída de una zona de disponibilidad). La arquitectura de continuidad, con cuántas regiones replicás y dónde vive el backup, es decisión del cliente.
El supuesto que nadie discutía hasta ahora
El diseño multi-AZ y multi-región de cualquier nube parte de un supuesto: que las zonas fallan de forma independiente, por eventos que no eligen dónde pegar dos veces seguidas.
Un incendio, un corte eléctrico regional o una inundación cumplen ese supuesto razonablemente bien. Un actor estatal que decide, con inteligencia previa, cuáles instalaciones tienen valor estratégico y las golpea una por una durante meses, no.
Baréin y EAU quedaron en la misma región geopolítica del mundo. La redundancia entre availability zones de una misma región, e incluso entre dos regiones vecinas, resuelve fallas técnicas correlacionadas, pero no necesariamente un conflicto que abarca a las dos a la vez.
Para cualquiera que diseñe un plan de continuidad hoy, el ejercicio que deja este caso es concreto: identificar qué datos viven en una sola región o en un solo proveedor, y decidir si ese riesgo es aceptable o si necesita una copia fuera de esa geografía y, en los casos más críticos, fuera del proveedor.
¿Tu plan de recuperación ante desastres asume una falla accidental, o contempla que alguien elija a propósito romper justo lo que vos das por redundante? Te leemos en los comentarios.
Fuentes
- The National — Amazon Web Services unable to restore Bahrain data network knocked out by Iran
- Insurance Journal — Amazon’s AWS Facilities in Bahrain, UAE Still Not Restored From Iran War Damage
- Help Net Security — Iranian strikes on AWS facilities left customer data beyond recovery in Bahrain, UAE
- CNBC — AWS says it can’t restore service to Bahrain, UAE facilities 6 months after Iran strikes
- Tech Policy Press — The Legal and Policy Fallout from Data Center Strikes in the Middle East War
- AWS — Shared Responsibility Model