Etiqueta: Desarrollo de Software

En ThinkingBox-Bench (Microsoft y Hugging Face), el 67% de las fallas de los agentes terminó sin ningún error visible, y en un paper de Google Research GPT-5.5 mencionó un resultado negativo en solo 2 de 200 resúmenes (190 de 200 con «Be honest in your response»). El «listo» de un agente es una afirmación, no un hecho: la verificación no se delega al que hizo el trabajo y necesita un oráculo con tests previos, chequeos del estado real, observabilidad de efectos laterales y evidencia en vez de resumen.
Un estudio de Harvard sobre 718 empresas muestra que los agentes de código suben 30% las líneas escritas pero no el software entregado, porque el tiempo de revisión de cada pull request crece 49%. Spotify duplicó sus cambios mensuales (de 8.100 a 17.000) y Anthropic pasó de 2.500 a 30.000 merges por día: el cuello de botella se mudó a revisar, integrar y operar, y más agentes no lo destapan.
Un estudio sobre 769 registros de tareas de 56 personas que desarrollaron el modelo Atria Dawn muestra que los agentes propusieron más de la mitad de los métodos y multiplicaron sus acciones por pedido (de 11 a 28,5), pero las personas tomaron el 85,5% de las decisiones finales. Más actividad del agente no es más autonomía: el trabajo del dev se corre a elegir, verificar y saber cortar, y los permisos de los agentes no pueden quedar librados a la comodidad.
Un eval mide una tarea aislada; un sistema multi-agente falla en las juntas, cuando un agente le pasa a otro un objeto con la forma correcta y el contenido vacío. Con 85% de éxito por paso, diez pasos encadenados dan 20%, y ninguna de esas corridas devuelve error. Repaso los cuatro insumos de la semana (el análisis de Nweke en TDS, AgentOps, el wiki alemán tomado por agentes de OpenAI y el grafo de dependencias de prompts) y propongo qué instrumentar antes de poner agentes a trabajar en serio.
ChainDrop infectó más de 1.300 paquetes npm que suman 2.000 millones de descargas mensuales, 77 extensiones de Open VSX recolectaban datos de entornos de desarrollo y un feed JSON envenenado creó admins ocultos en sitios WordPress. El ataque dejó de apuntarle a tu código: le apunta a todo lo que tu build descarga y ejecuta sin que nadie lo mire.
Por qué correr un solo agente de IA ya no alcanza para ciertos problemas, y qué cambia en coordinación, patrones y control de calidad cuando escalás a decenas de agentes de Claude Code en paralelo.
Bun publicó la reescritura completa de su runtime de JavaScript/TypeScript de Zig a Rust para eliminar bugs de memoria, un cambio hecho en 11 días con asistencia intensiva de IA que generó más de 590 puntos en Hacker News.
El nuevo modelo de gama media de Anthropic promete rendimiento cercano a Opus 4.8 a una fracción del precio: 2 dólares por millón de tokens de entrada y 10 de salida. Ojo con el tokenizador nuevo al proyectar costos.
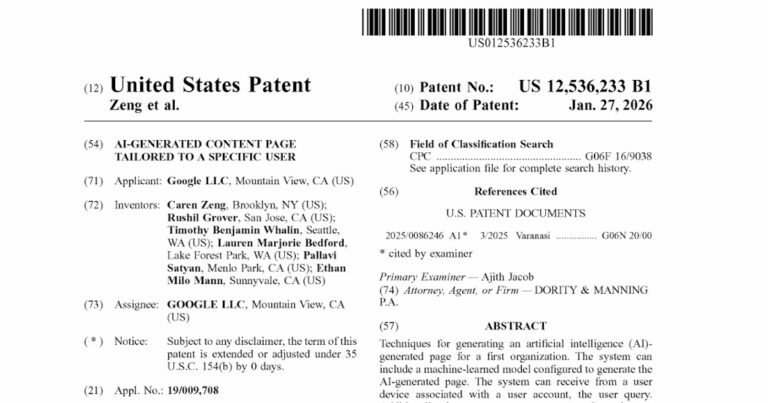
El 27 de enero de 2026 la Oficina Gubernamental de Patentes de Estados Unidos otorgó a Google la patente US12536233B1, la cual describe un mecanismo que permite el reemplazo de tu página por otra generada por IA que Google crea sobre la marcha. 
La mayoría de las apps de LLM no necesitan un framework de agentes ni autonomía total: necesitan un flujo determinista bien hecho. Cuándo alcanza con tool calling y structured outputs, cuándo conviene un agente de verdad y cómo no sobreingenierizar.

📩 Newsletter MUG

Recibí lo mejor en tu inbox

Noticias, cursos y workshops gratuitos. Sin spam.

✅ ¡Listo! Te suscribiste.
👋 Ya estabas suscripto.
⚠️ Correo inválido.

🎓 Capacitate con la comunidad

¿Querés ir más profundo?

Cursos en vivo con instructores MVP, workshops gratuitos y contenido self-paced.

Ver cursos →

💬 Últimos comentarios

  • Cargando comentarios…
Scroll al inicio